OpenCode 喂饭教程(下):7 个让我从"对话工具"切到"开发协作系统"的必装插件
系列第三篇。上篇我们装好了 OpenCode、接通了 DeepSeek;中篇讲透了 Plan/Build 双模式和 Slash 命令。这篇收尾——讲真正决定你能不能把 OpenCode 当生产力工具用的那一层:插件生态。
模型再强,也救不了残缺的工作流
我自己用 OpenCode 用了几个月。一开始的状态和大多数人一样:问一句、答一句、改一句。模型确实强,能跑通,但每次跑完一个稍复杂的任务,总觉得哪里别扭——上下文越拉越长、账单不知不觉涨上去、AI 写出来的代码还得手动过一遍规范、有用的分析过程散落在对话里再也找不回来。
后来我慢慢补插件,补到第七个的时候回头看,才发现一个事:真正拉开差距的,不是提示词技巧,也不是模型选型,而是有没有把插件生态用起来。
OpenCode 这类工具里,插件不是"多一个按钮",它是工作流组件。它决定的是这几个问题能不能被解决:
- 复杂任务能不能拆分并行
- 外部信息能不能实时获取
- 成本能不能被追踪和控制
- 生成代码能不能快速进入可提交状态
- 过程知识能不能沉淀复用
这些环节缺一个,再强的模型也会退化成"高级对话工具"。这篇只讲一件事:如果想把 OpenCode 用得接近生产环境,哪些插件值得优先配?
我把常见需求拆成 5 类——多 Agent 协作、Token/成本监控、联网搜索、代码质量检查、知识沉淀。下面这 7 个插件,就是按这个框架挑出来的一组组合。
一、先说结论:插件的价值是补齐工作流,不是堆功能
很多人误以为插件就是功能扩展。但在 OpenCode 这种 TUI 工具里,插件更像工作流组件。它的意义不是"让你多一个按钮",而是决定前面说的那几个关键问题能不能被解决。
如果这些环节缺失,那么再强的模型,实际体验也很容易退化成"高级对话工具"。
所以这篇文章的核心判断是一句:模型决定基础能力,插件决定实际可用性。
二、7 个值得关注的 OpenCode 插件
1. oh-my-opencode:最值得优先装的多 Agent 插件
如果只能选一个插件优先安装,我把票投给 oh-my-opencode。
原因不复杂——它优化的不是某一个局部能力,而是直接改变了 OpenCode 的工作方式:从单一助手,变成可分工的多 Agent 协作系统。
核心能力:
- 多模型协同:支持 Claude、OpenAI、Gemini、Copilot 等
- 多智能体分工:不同 Agent 承担探索、规划、审查、搜索等职责
- 并行任务执行:后台并发处理
- LSP / AST 工具增强:更适合代码理解与结构分析
- 任务跟踪:内置 Todo 管理
为什么它重要? 真实开发里,复杂任务通常不是"生成一段代码"这么简单,而是包含多个步骤:熟悉代码库 → 查找相关模块 → 分析已有模式 → 搜文档或外部资料 → 拆解需求 → 执行改动 → Review 结果。如果这些都由单个上下文串行完成,效率和稳定性都会受影响。
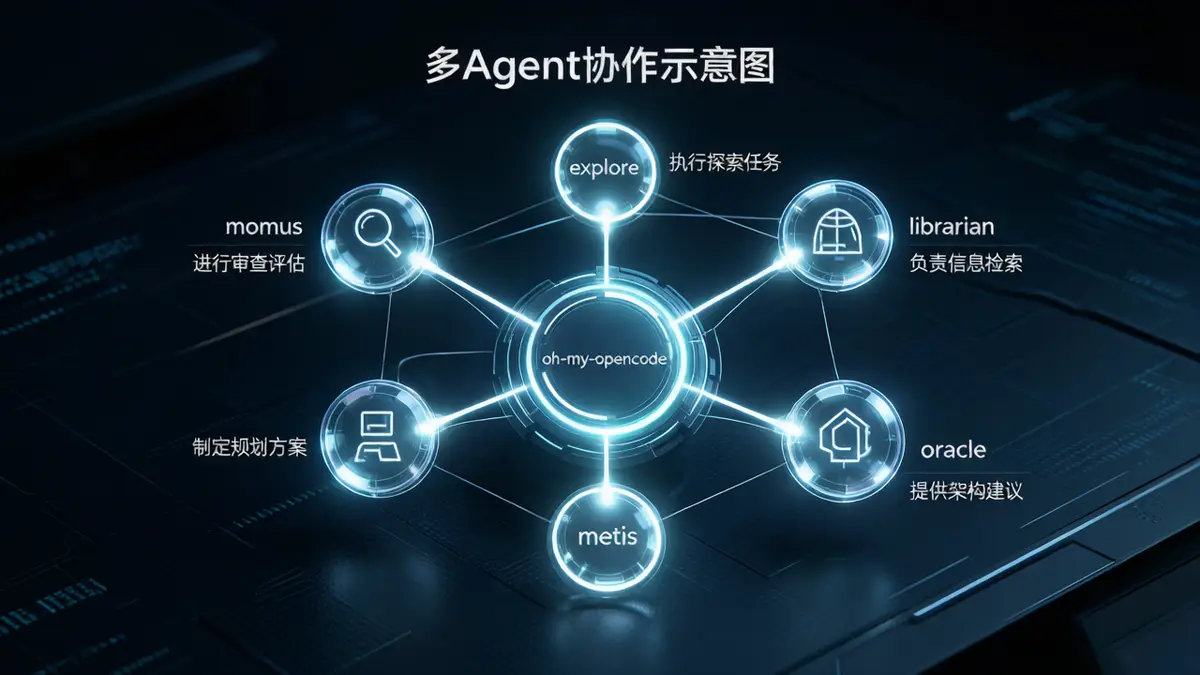
而 oh-my-opencode 的价值,就是把这些步骤拆给不同角色处理。典型 Agent 分工:
- explore — 探索代码库、定位相关逻辑
- librarian — 搜索外部文档、仓库、资料
- oracle — 架构分析、复杂问题判断
- metis — 任务规划、拆解需求
- momus — 代码评审、质量检查
这种设计很适合中大型项目,尤其是你对代码库并不完全熟悉的时候。
安装方式:
# 免费模式(不启用外部模型)
npx oh-my-opencode@latest install --no-tui --claude=no --gemini=no --copilot=no

# 若已有订阅,可以启用对应模型
npx oh-my-opencode@latest install --no-tui --claude=yes --gemini=yes --copilot=yes
适合什么人? 经常处理多文件改动的人、要做新功能开发的人、要接手历史项目的人、希望把 OpenCode 从"助手"升级为"协作系统"的人。
我的评价: 这是我认为最接近"生产力杠杆"的一个插件。上手成本略高,但收益也最大。
2. opencode-token-monitor:成本控制必备,重度用户尤其要装
第二个我认为优先级很高的是 opencode-token-monitor。
很多人用 AI 编程工具时容易只关注"能不能做出来",忽略"做出来花了多少钱"。但一旦进入高频使用阶段,token 成本就不再是小问题。这个插件的价值在于:把原本不可见的成本,变成可观测、可分析的数据。
核心能力:
- 实时监控 input / output / reasoning / cache token
- 根据模型定价估算调用成本
- 按 Agent 统计消耗
- 按模型统计使用情况
- 分析哪些工具调用最耗资源
为什么值得装? 很多时候成本高不是因为任务复杂,而是因为:上下文过长、反复搜索、Agent 分工不合理、模型选型过重、工具调用过多。没有可视化手段,你只能"感觉变贵了";有了监控之后,才能真正优化工作流。
安装与配置:
npm install -g opencode-token-monitor在 opencode.json 中添加:
{
  "plugin": ["opencode-token-monitor"]
}
适合什么人? 经常跑复杂任务的人、团队多人共享使用的人、对预算敏感的人、想优化 agent 工作流的人。
我的评价: 它不是最炫的插件,但很实用。尤其在长期使用时,价值会越来越明显。
3. opencode-google-search:解决"模型知道,但信息不够新"的问题
第三类能力是联网搜索。模型本身可以推理,也能解释很多技术概念,但在以下场景中,时效性往往比推理能力更重要:新版本特性、官方文档更新、最新发布动态、社区讨论、近期兼容性变化。
这时候如果 OpenCode 不能联网,就容易出现信息滞后。opencode-google-search 的作用,就是把实时搜索能力接进来。
核心能力:
- Google 搜索集成
- 获取最新网页信息
- 支持技术文档与资讯检索
- 基础能力可通过 OAuth 使用
安装方式:
npm install -g opencode-google-search授权方式: 通常需要启动 OpenCode,在对话中执行安装相关操作,选择 Google OAuth 授权,登录账号完成绑定。
使用场景:
- "帮我搜索 React 19 的最新特性"
- "查一下 TypeScript 5.4 的更新"
- "看看某个库最近有没有 breaking change"
它的边界: 需要说明的是,联网搜索不等于结果自动可靠。它解决的是"获取信息"的问题,不直接解决"信息筛选"的问题。所以更合适的使用方式是——搜索 + 摘要 + 交叉验证。
我的评价: 如果你的工作依赖最新文档和技术动态,这个插件值得装;如果你的任务基本都围绕稳定老项目,优先级可以稍低。
4. @zhafron/mcp-web-search:作为搜索能力的补充和兜底
如果说 opencode-google-search 更像主搜索入口,那么 @zhafron/mcp-web-search 更像一个增强型补充方案。
它的主要优势是:
- 支持多个搜索提供商
- 支持自动回退
- 支持网页内容提取
- 支持转换成 Markdown
支持的搜索源: DuckDuckGo、Bing、SearXNG。
它适合什么场景?我希望减少对单一搜索源依赖、需要抓取网页正文而不是只看摘要、想把搜索结果进一步纳入 AI 分析流程。
安装方式:
npm install -g @zhafron/mcp-web-search在 opencode.json 里配置:
{
  "mcp": {
    "web-search": {
      "command": "npx",
      "args": ["-y", "@zhafron/mcp-web-search"],
      "type": "stdio"
    }
  }
}
客观提醒: 这个插件在不同环境下的兼容性可能有差异,尤其是 Windows 环境下,实际体验可能不如 Linux / macOS 稳定。所以我会把它定义为——值得尝试的搜索增强插件,但不是最稳妥的第一优先级选择。
我的评价: 适合对搜索鲁棒性有要求的用户,但建议先看自己本地环境兼容情况。
5. @nano-step/skill-manager:把重复任务做成"可复用技能"
这个插件的思路很有代表性:不要每次都从零发起任务,而是把高频动作沉淀成技能模板。
这件事的意义,很多人一开始感受不强,但只要使用频率高,收益会越来越明显。
它能做什么? 安装技能、更新技能、查看可用技能、查看已安装技能、删除不需要的技能。
常用命令:
npm install -g @nano-step/skill-manager
npx skill-manager list
npx skill-manager install skill-management
npx skill-manager installed
npx skill-manager update
为什么这类插件重要? 因为很多 AI 使用场景本质上是重复劳动——分析需求、输出任务拆解、检查 token、做代码审查、生成固定结构的总结。如果每次都重新描述,不仅效率低,也会增加 token 消耗。技能模板化之后,调用成本和认知负担都会下降。
它更适合谁? 有稳定工作流的人、经常做重复型开发任务的人、团队想统一提示词规范的人。
我的评价: 这是一个更偏"长期主义"的插件。短期体验未必最惊艳,但一旦形成习惯,会明显改善复用效率。
6. opencode-eslint-formatter:提升 AI 代码的落地质量
很多人用 AI 写代码时,会遇到一个典型问题:代码能生成,但未必能直接进项目。
常见原因:风格不一致、ESLint 规则不通过、存在一些基础语法或规范问题、需要人工二次整理。opencode-eslint-formatter 的价值,就是把规范检查尽量前置。
核心能力:
- 自动识别项目中的 ESLint 配置
- 将 ESLint 集成到格式化 / 检查流程
- 实时提示规范问题
- 支持自动修复部分错误
安装方式:
npm install -g opencode-eslint-formatter依赖前提: 项目中最好已有 ESLint 配置,例如 .eslintrc.js、.eslintrc.json、eslint.config.js。如果还没有,可以这样初始化:
npm install eslint --save-dev
npx eslint --init
常用操作:
npx eslint src/
npx eslint src/ --fix
为什么它实用? 因为 AI 编程真正的瓶颈,很多时候不是"写不出来",而是"写出来之后还要修很久"。而代码规范工具的作用,就是尽量缩短从"可运行"到"可提交"的距离。
我的评价: 对于前端、Node、TypeScript 项目来说,这类插件几乎是刚需;如果团队本来就严格使用 ESLint,那优先级很高。
7. @xeaser/opencode-obsidian-sync:把会话记录转化为知识资产
最后这个插件,很多人可能会低估。因为它不直接提升"写代码的即时速度",但它提升的是另一件更重要的事——把每次和 OpenCode 的交互过程沉淀下来。
核心能力:
- 会话结束后自动同步到 Obsidian
- 生成结构化 Markdown
- 自动添加标签
- 支持 Dataview 元数据查询
安装方式:
npm install -g @xeaser/opencode-obsidian-sync配置方式:
{
  "plugin": ["@xeaser/opencode-obsidian-sync"]
}
它解决了什么问题? AI 使用中有个普遍现象——很多很有价值的分析过程,最后都散落在对话里,没有沉淀。比如某次问题排查的完整路径、某个架构讨论的取舍逻辑、某次功能设计的演进过程、某个 bug 的最终定位方法。如果这些内容能自动进入 Obsidian,就会逐渐形成自己的知识库。
适合什么人? 喜欢做技术沉淀的人、用 Obsidian 做个人知识管理的人、想建立团队经验库的人。
我的评价: 短期收益不如搜索或多 Agent 直观,但长期价值非常高。适合重视复盘和知识积累的用户。
三、按优先级排序,我会怎么推荐?
如果你不想一次装太多,可以按这个顺序来。
第一优先级:先补核心工作流
oh-my-opencode— 协作效率
opencode-token-monitor— 成本可见性
opencode-eslint-formatter— 交付质量
这三个分别对应协作、成本、质量,是最接近"生产环境刚需"的一层。
第二优先级:再补信息获取能力
opencode-google-search
@zhafron/mcp-web-search
适合需要频繁查新、查文档、做外部检索的人。
第三优先级:补沉淀和复用
@nano-step/skill-manager
@xeaser/opencode-obsidian-sync
这两个更偏长期收益,适合高频重度用户。
四、不同场景下,插件组合怎么选?
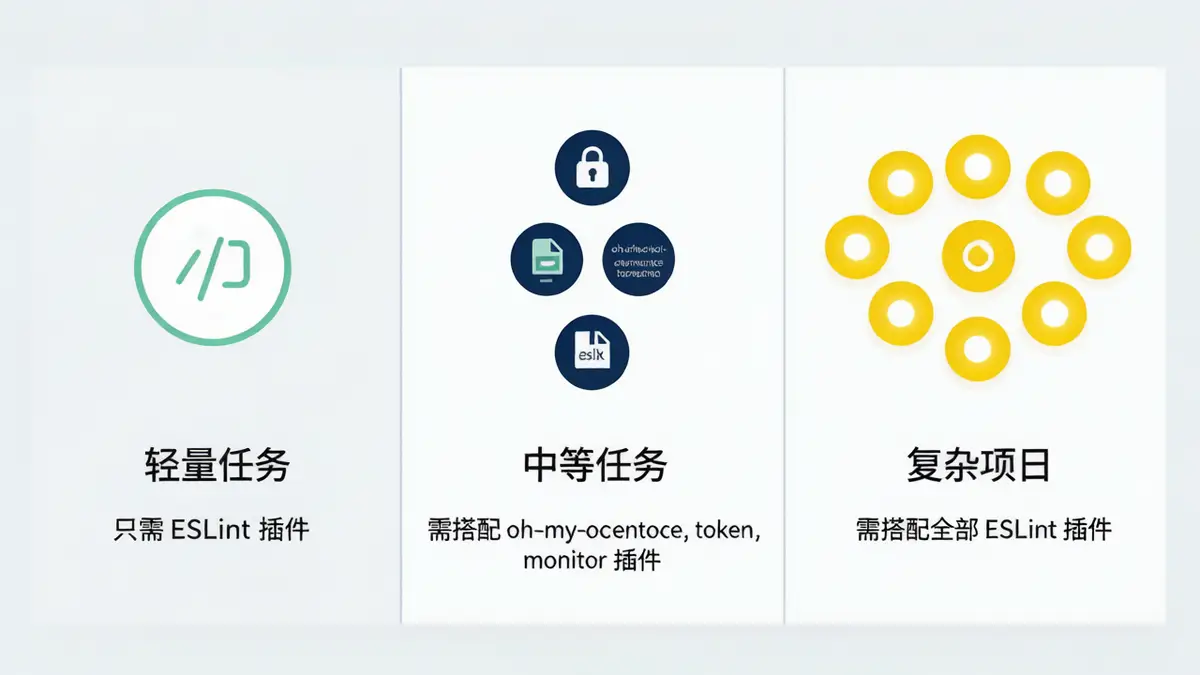
1. 轻量级编码任务(修一个小 bug、改一个单文件逻辑、增加一个简单表单项)
推荐:opencode-eslint-formatter。任务很轻,不必上太复杂的协作链路。
2. 中等复杂度任务(多文件联动修改、增加中小型功能、接手已有模块做迭代)
推荐组合:
oh-my-opencode
opencode-token-monitor
opencode-eslint-formatter
这时多 Agent 协作开始体现价值。
3. 复杂项目或陌生代码库(新功能从 0 到 1、大范围重构、历史项目接手、需要频繁查文档和外部资料)
推荐组合:全部 7 个。这是比较完整的一套生产力配置。
五、客观的结论:不是所有插件都适合所有人
最后强调一句:这 7 个插件并不是"无脑全装就最好"。
更合理的思路应该是——先明确你的主要瓶颈在哪,再按瓶颈补插件,最后通过实际任务验证效果。
举例来说:
- 如果你主要问题是代码规范不过,先装 ESLint 插件
- 如果你主要问题是复杂任务推进慢,先装多 Agent 插件
- 如果你主要问题是账单不可控,先装 token 监控
- 如果你主要问题是信息过时,先补搜索能力
- 如果你主要问题是经验无法沉淀,再考虑 Obsidian 同步
也就是说,插件配置的本质不是"堆满",而是"对症"。
六、收尾:OpenCode 系列三篇讲完了
如果让我用一句话概括这次评测结论,那就是——OpenCode 的上限,不只取决于模型本身,更取决于你有没有把插件生态转化为稳定工作流。
在这 7 个插件里:
| 定位 | 插件 |
| 最值得优先尝试的 | oh-my-opencode |
| 最容易被低估的 | opencode-token-monitor |
| 最实用的质量保障类 | opencode-eslint-formatter |
| 最适合高频查新的增强 | opencode-google-search |
| 最适合长期主义用户的 | @xeaser/opencode-obsidian-sync |
| 最适合复用工作流的 | @nano-step/skill-manager |
如果你的目标不是"体验一下 AI 编程",而是把 OpenCode 真正纳入日常开发体系,那么插件配置这一步,基本绕不过去。
系列回顾:
- 下篇(本篇):OpenCode 插件生态全解:7 个必装插件+三场景组合推荐
官方插件列表参考: https://opencode.ai/docs/ecosystem#plugins
到这里 OpenCode 喂饭教程三篇就讲完了。如果你跟着三篇走下来,从装、到用、到插件生态,已经具备把 OpenCode 当主力开发协作工具用的完整基础。剩下的,就是在真实项目里一遍遍打磨工作流——这件事没有捷径,但方向是对的。




这个写的很好,真详细
给力!!!!!!