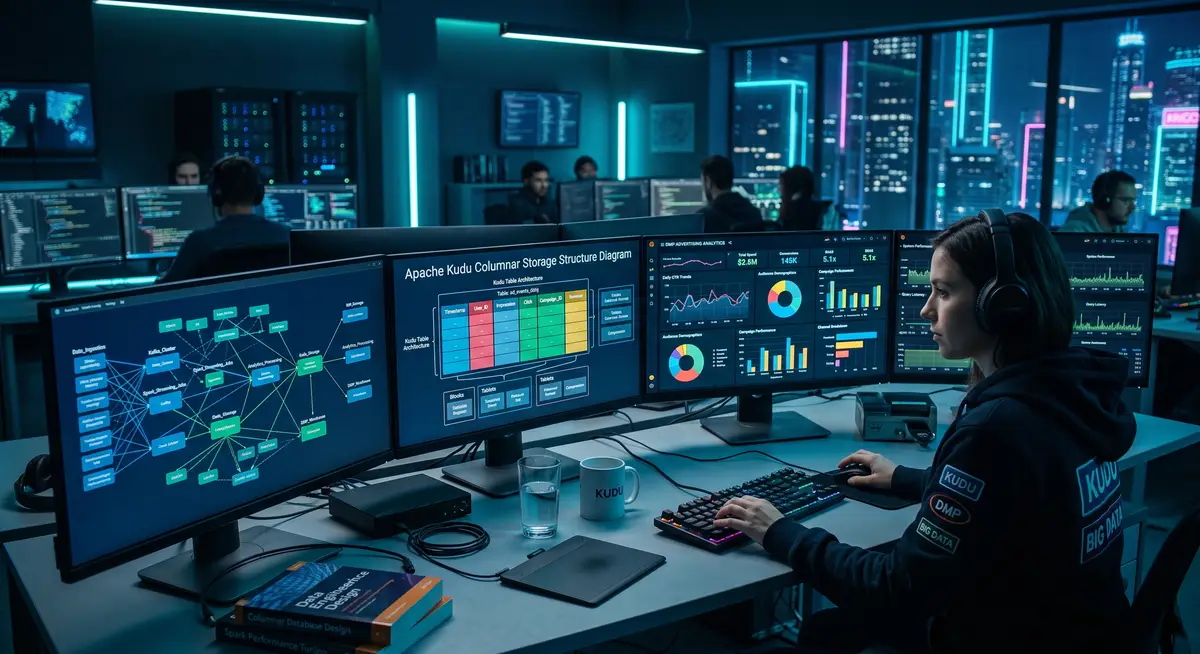
Kudu+Spark实战:企业级DMP广告智能投放系统开发全景解析
在传统大数据架构中,HDFS适合海量批处理,HBase适合高并发随机读写,但面对需要兼顾高吞吐量扫描与快速实时更新的商业分析场景时往往捉襟见肘。Apache Kudu 作为新型列式存储系统,完美填补了 Hadoop 存储层的这一空缺。本实战课程直接对标一线互联网大厂的数据营销架构,带你彻底跑通基于 Kudu 的企业级 DMP(Data Management Platform)系统。
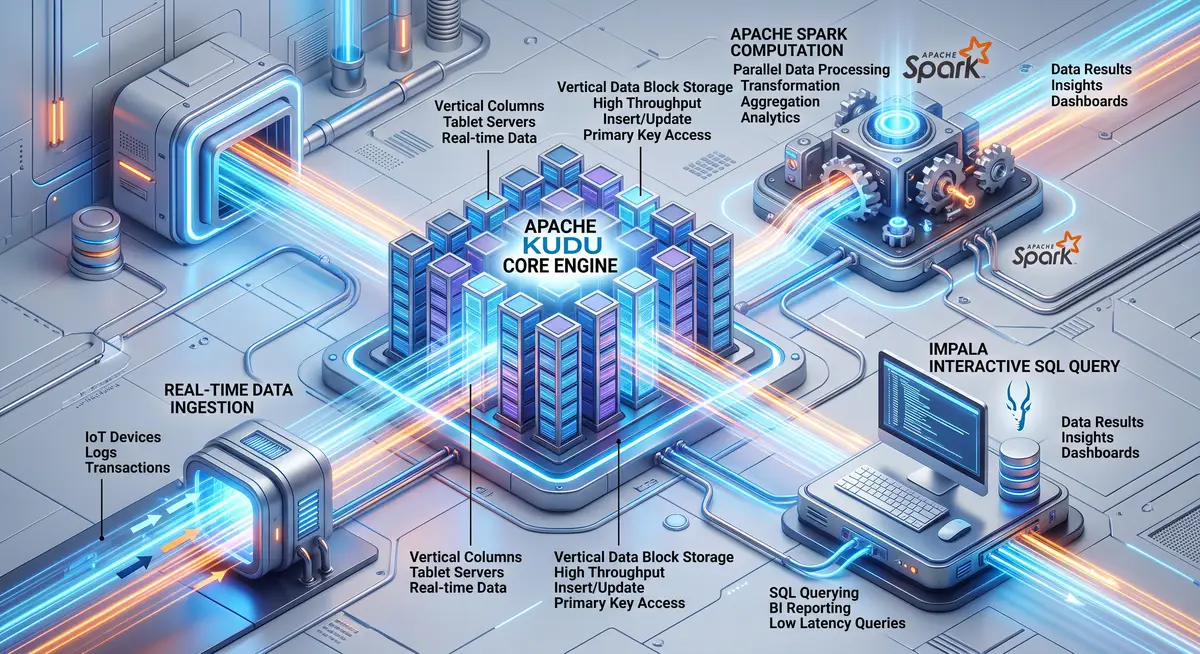
核心技术与工程模块
-
CDH环境与Kudu引擎部署:摒弃不稳定的单机测试环境,实战演示从虚拟机网络配置到 Zookeeper、Hadoop、Hive、Impala 及 Kudu 的完整 CDH 集群搭建,深度剖析 OLAP 与 OLTP 的边界及列式存储原理。
-
Kudu与Spark深度整合:掌握 Kudu 工具类封装与隐式转换,利用 Spark DataFrame 进行海量数据的快速读写,并无缝对接 Impala 实现极速查询。
-
IP转换与报表系统:整合 IP2Region 和 GeoLite 进行高精度 IP 定位解析,配合自定义底层执行框架,完成广告投放区域分布的精准离线统计。
-
商圈库与Http接口交互:基于 TCP/Http 协议,利用 OkHttp 和 JSON4S 工具类处理外部LBS接口数据,结合 UDF(用户自定义函数)实现经纬度求差与商圈范围的精准圈定。
-
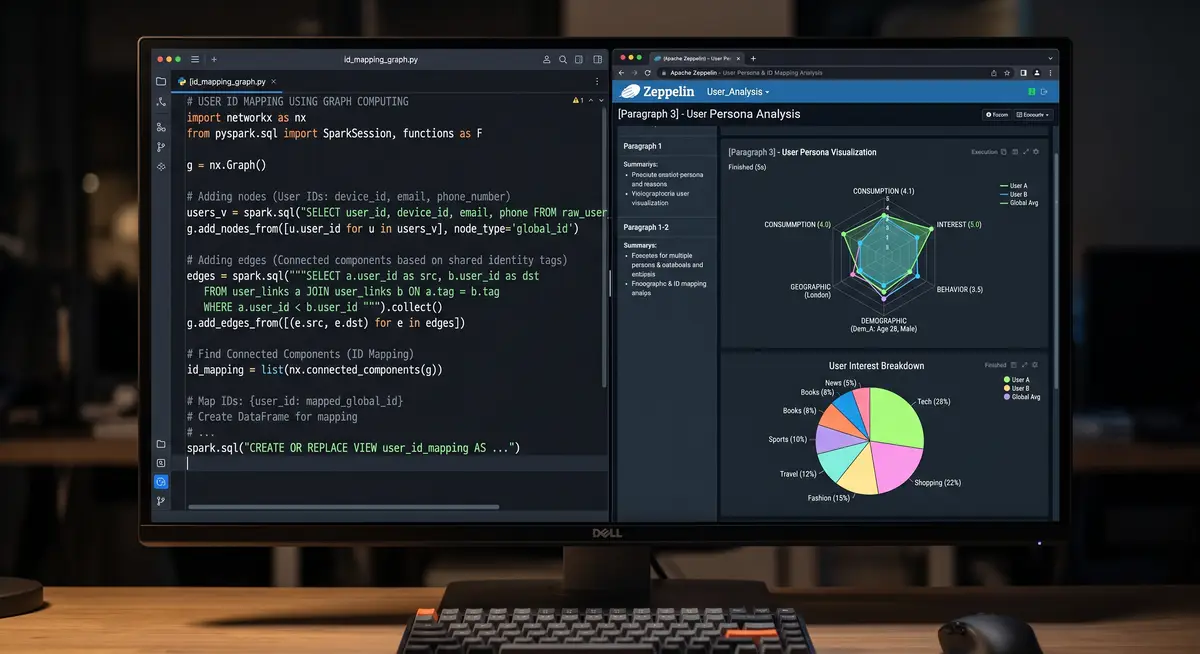
图计算与用户画像标签:还原真实的“打标签”业务逻辑。利用图计算框架进行统一用户识别(ID Mapping),实现复杂的用户标签聚合,并结合 Apache Zeppelin 进行数据的交互式可视化探索。
掌握该 DMP 系统架构,你将跳出单一的“写SQL”困境,深刻理解从数据接入、存储引擎选型优化,到复杂离线计算与前端可视化的全链路大数据场景。这不仅是 Kudu 的最佳实践,更是大数据开发工程师迈向底层架构设计的必经之路。
权威外链与参考文献
为了帮助开发者在构建 DMP 系统时顺利完成 CDH 集群搭建、深入理解 Kudu 原理及熟练运用可视化工具,以下整理了核心技术的官方资源入口:
-
关联价值:了解 Kudu 作为新型列式存储引擎的底层架构设计,查阅其与 Hadoop 体系(HDFS/HBase)的性能基准对比,为系统技术选型提供理论支撑。
-
关联价值:实操“Kudu与Spark整合”模块的必备手册。查阅最新的 Spark SQL 与 DataFrame API,掌握高效的数据处理与读写算子调优技巧。
-
关联价值:CDH 是企业级 Hadoop 集群管理标准。在“系统搭建”阶段,遇到 Zookeeper、Impala 或 Kudu 的依赖冲突或网络端口问题时,此处提供最详尽的排障指南。
-
关联价值:数据探索与可视化利器。学习如何配置 Zeppelin 的 Interpreter(解释器),直接连接 Spark 与数据仓库,通过 Web UI 实时渲染用户画像与投放报表。
-
关联价值:Scala 环境下处理 JSON 数据的核心类库。在“商圈库开发”中,结合 Http 请求获取的数据通常为复杂 JSON 结构,掌握 JSON4S 的 AST 解析能极大提升开发效率。
🔒 此内容为积分资源
登录后使用积分解锁查看